L'intégration de l'IA pour e-commerce génère une rentabilité mesurable uniquement lorsqu'elle repose sur un pipeline de données assaini, une architecture distribuée robuste et des synchronisations asynchrones entre le catalogue et les modèles d'inférence. Loin du simple gadget conversationnel ou du widget tiers superficiel, l'intelligence artificielle appliquée à la vente en ligne exige un couplage technique profond entre les journaux d'événements utilisateurs, la gestion des stocks et les moteurs de tarification. Ce guide détaille les composants logiciels indispensables au déploiement de modèles prédictifs sur des boutiques en ligne, formalise l'architecture de données requise et met en lumière les défaillances d'ingénierie courantes lors de l'intégration de grands modèles de langage et d'algorithmes de recommandation.
L'intelligence artificielle pour le commerce électronique désigne l'ensemble des modèles algorithmiques, des pipelines d'apprentissage automatique et des flux de données en temps réel conçus pour analyser le comportement des acheteurs afin d'adapter dynamiquement les catalogues, les parcours d'achat et les recommandations de produits.
Les couches d'architecture d'un système d'IA pour e-commerce
L'intégration pérenne de solutions d'intelligence artificielle au sein d'une boutique en ligne impose un découplage strict entre la couche de présentation front-end, la logique métier du panier et le traitement lourd des données. Les déploiements qui échouent commettent fréquemment l'erreur d'exécuter des requêtes d'inférence synchrones directement sur la base de données transactionnelle de la boutique ou d'interroger des API de modèles de langage sans mémoire tampon ni couche intermédiaire, ce qui détériore le temps de réponse serveur et impacte directement le taux de conversion.
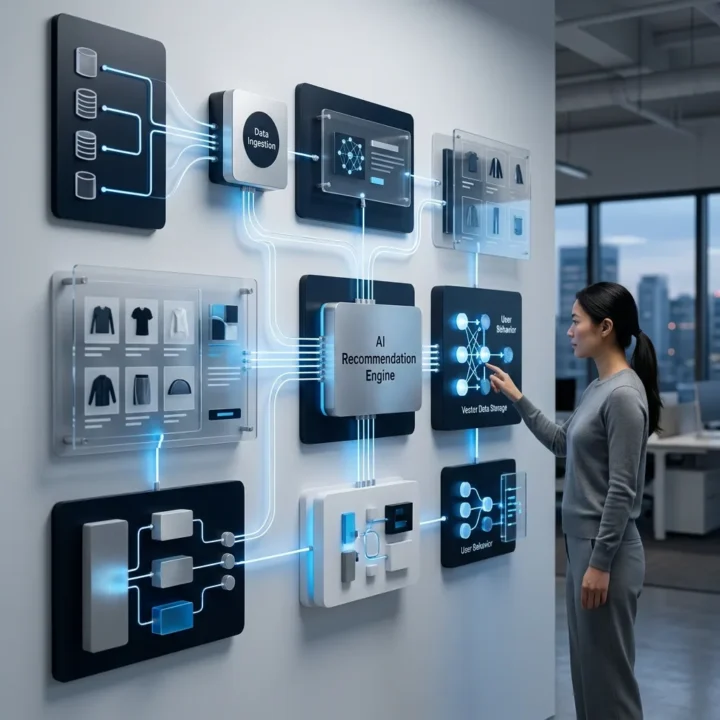
Une infrastructure moderne et résiliente s'articule autour de quatre couches fondamentales :
- La couche d'ingestion d'événements (Event Ingestion Layer) : journalisation granulaire de chaque interaction client (consultation de produit, ajout au panier, profondeur de défilement, temps de session). Ces signaux sont expédiés de manière asynchrone vers un bus d'événements distribué afin d'éliminer tout blocage du fil d'exécution principal du navigateur.
- La couche de traitement et de persistance (Data Pipeline & Storage) : les flux bruts subissent une normalisation et sont stockés dans un entrepôt de données analytique ou au sein d'une base vectorielle spécialisée. Ce dispositif constitue le socle indispensable au développement IA et LLM fondé sur la recherche contextuelle et le partitionnement vectoriel.
- La couche d'inférence et de calcul prédictif (Inference Engine) : modules logiciels exécutant, en temps réel ou par lots programmés (batch processing), le scoring des paniers, l'estimation des probabilités d'abandon et le reclassement personnalisé des listes de résultats.
- La couche d'exposition et de distribution en périphérie (API & Edge Delivery) : distribution des résultats personnalisés au client via des points de terminaison REST API optimisés et des mécanismes de mise en cache sur le réseau périphérique (Edge Caching).
Cette rigueur d'ingénierie permet d'alimenter directement des infrastructures modernes d'ingénierie e-commerce headless, découplant totalement l'expérience utilisateur des moteurs de calcul sous-jacents.
| Composant architectural | Technologie préconisée | Responsabilité technique dans le système |
|---|---|---|
| Ingestion d'événements | Apache Kafka ou AWS Kinesis | Collecte asynchrone en temps réel des actions utilisateurs sans latence sur la page |
| Base de données vectorielle | Pinecone, Qdrant ou pgvector | Recherche sémantique, calcul de proximité vectorielle et extraction contextuelle |
| Moteur de recommandation | Modèles sur mesure ou filtrage collaboratif | Calcul d'affinité produit et cross-selling basé sur l'historique d'achat |
| Point de terminaison Edge | Cloudflare Workers ou AWS Lambda | Injection des recommandations personnalisées en moins de 50 millisecondes |
Moteurs de recherche sémantique et recommandations vectorielles
La recherche textuelle conventionnelle sur les plateformes de commerce électronique repose historiquement sur la correspondance exacte de chaînes de caractères (lexical matching). Lorsqu'un internaute formule une requête descriptive comme « robe légère pour cocktail estival », un moteur relationnel SQL ou un index inversé standard renvoie un ensemble vide ou tronqué si les mots exacts ne figurent pas explicitement dans les attributs textuels du produit.
À l'inverse, les moteurs de recherche sémantique s'appuient sur des Vector Embeddings pour transformer la fiche technique du catalogue et la requête utilisateur en vecteurs numériques au sein d'un espace multidimensionnel dense. En appliquant des architectures de type RAG (Retrieval-Augmented Generation), l'infrastructure calcule la similarité cosinus (Cosine Similarity) entre l'intention d'achat réelle et les propriétés dimensionnelles des articles disponibles. Pour analyser en profondeur l'autonomie croissante des parcours d'achat, vous pouvez consulter notre dossier sur l'e-commerce pour agents IA. Pour les normes relatives à l'indexation vectorielle native, référez-vous à la documentation officielle Elasticsearch sur la recherche sémantique.
Ce type de transformation impose une coordination millimétrée avec l'équipe produit : l'affichage des recommandations dynamiques ne doit ni provoquer de décalage de mise en page (Cumulative Layout Shift) ni alourdir le DOM initial. Une conception rigoureuse centrée sur le design UX et UI garantit que les suggestions contextuelles s'intègrent sans heurts dans le tunnel d'achat, sans surcharger cognitivement l'acheteur.
Optimisation dynamique des catalogues marchands par traitement du langage naturel
Pour les catalogues volumineux comprenant des dizaines de milliers de références (SKU), l'hétérogénéité des données fournisseurs représente un écueil critique. Les modèles de traitement automatique du langage naturel (NLP) permettent d'industrialiser la standardisation des flux produits :
- Catégorisation et extraction d'attributs automatiques : identification instantanée de la matière, de la coupe, de la couleur et de la saisonnalité depuis les descriptions textuelles non structurées et les images pour remplir les taxonomies de la base.
- Génération de descriptions contextuelles : déclinaison dynamique d'arguments commerciaux en fonction de la provenance géographique ou de la typologie d'audience, dans le respect strict des chartes de marque.
- Détection d'anomalies de données : identification algorithmique des champs obligatoires manquants, des erreurs d'unités ou des divergences entre visuels et caractéristiques techniques avant toute mise en ligne.
Infrastructure d'intégration et synchronisation inter-systèmes
Les algorithmes d'IA ne peuvent fonctionner de manière isolée au sein de l'entreprise. Pour que les prédictions et les recommandations personnalisées soient viables sur le plan opérationnel, les modèles doivent disposer d'un accès synchronisé aux données de l'ERP, du CRM et des plateformes de gestion d'entrepôt (WMS). Un algorithme qui oriente un utilisateur vers une référence en rupture physique dans le centre de distribution régional détériore gravement l'expérience d'achat et la rentabilité logistique.
Pour prévenir ce risque, l'architecture doit impérativement s'appuyer sur une intégration de systèmes pilotée par les événements (Event-Driven Architecture) et des Webhooks sécurisés. Dès qu'une variation d'inventaire critique survient dans l'ERP, un message notifie le magasin vectoriel afin de retirer le produit des vecteurs de recommandation actifs en quelques millisecondes.
Les règles relatives à l'exécution décentralisée de code et à la confidentialité des acheteurs lors du traitement de modèles d'apprentissage sont cadrées par les spécifications du groupe W3C Web Machine Learning, qui préconisent le traitement d'inférence en périphérie (Edge) et le cloisonnement rigoureux des données nominatives.
Erreurs d'ingénierie courantes lors de l'intégration de l'IA pour e-commerce
L'expérience de terrain sur les architectures de vente à fort trafic montre que la majorité des dysfonctionnements ne découle pas des limites mathématiques des modèles, mais de défaillances de conception logicielle :
- Requêtes synchrones vers les LLM lors du rendu : solliciter une API d'inférence externe pendant la construction du document HTML dégrade le Time to First Byte (TTFB) de plusieurs secondes. Toutes les générations textuelles doivent être pré-calculées ou chargées de façon asynchrone.
- Fuite de données confidentielles (Data Leakage) : transférer des identifiants clients ou des historiques non pseudonymisés vers des modèles SaaS tiers enfreint les réglementations RGPD et affaiblit la sécurité globale de la plateforme.
- Absence de circuit de repli (Fallback Strategy) : tout service de recherche vectorielle ou de scoring d'affinité doit être encapsulé dans un mécanisme de disjonction (Circuit Breaker). Si la réponse dépasse 100 millisecondes, le système doit basculer instantanément sur l'index de recherche standard sans afficher d'erreur à l'utilisateur.
- Négligence de la dérive de modèle (Model Drift) : les tendances d'achat et les comportements saisonniers évoluent constamment. Un moteur de recommandation qui n'est pas ré-entraîné ou recalibré régulièrement sur des données fraîches perd sa pertinence prédictive en quelques semaines.
Pour structurer votre infrastructure de vente en ligne, concevoir des moteurs de recommandation sur mesure ou moderniser l'architecture de vos données transactionnelles, contactez notre équipe d'ingénieurs afin d'évaluer la faisabilité technique de votre projet.
Questions fréquentes
Qu'est-ce que l'IA pour e-commerce et en quoi diffère-t-elle d'un moteur de recherche classique ?
L'intelligence artificielle pour le e-commerce rassemble des modèles statistiques et d'apprentissage automatique analysant les signaux d'intention en temps réel pour adapter l'affichage du catalogue. Contrairement aux moteurs classiques limités à la correspondance textuelle stricte de mots-clés, l'IA interprète la sémantique vectorielle des requêtes et module les résultats selon le profil d'affinité de chaque acheteur.
Quel est l'impact de l'intégration de modèles d'IA sur la vitesse d'une boutique en ligne ?
Un appel synchrone à une API d'inférence lors du chargement de page allonge considérablement le délai de réponse serveur. Pour préserver les performances et le Core Web Vitals, les calculs doivent être réalisés de manière asynchrone, mutualisés via du cache en périphérie réseau (Edge Caching) ou générés en amont lors de tâches de fond hors ligne.
Une plateforme e-commerce doit-elle entraîner son propre LLM ou exploiter des modèles cloud ?
Dans l'immense majorité des cas d'usage marchands, l'entraînement d'un grand modèle linguistique propriétaire à partir de zéro est financièrement et techniquement injustifié. L'approche standard consiste à exploiter des modèles pré-entraînés via des API hébergées, en les combinant à une base vectorielle privée alimentée par le catalogue au sein d'une architecture RAG.
Quelles données sont indispensables pour entraîner un moteur de recommandation e-commerce performant ?
Un moteur de recommandation requiert trois sources de données interconnectées : les métadonnées techniques du catalogue produit, l'historique exhaustif des transactions passées et les événements de navigation en temps réel (clics, ajouts au panier, durée d'affichage des fiches). L'association de ces trois dimensions permet de calculer des proximités d'affinité fiables.
Partager cet article
Envie qu’on y jette un œil ?
Dites-nous ce que vous construisez, réponse sous un jour ouvré.